Обучаем LLM в нефтегазе: как превратить корпоративный архив в живого эксперта
Спускаемся с облака на землю
В нефтегазовой отрасли накоплены терабайты данных. Это не просто тексты — это геология, застывшая в кернах и каротажных диаграммах, и инженерия, записанная в отчетах ГРП, PVT-отчетах и проектах разработки.
Публичные ИИ-сервисы предлагают преимущественно облачные решения, но для нефтегаза они неприемлемы: запрет политики безопасности и требования по защите гостайны ставят крест на облачных технологиях.
Единственный путь — локальное обучение компактных open-source моделей внутри защищенного контура предприятия.
Самостоятельное обучение LLM пока доступно очень ограниченному кругу компаний. Полноценная LLM заменяется на настройку корпоративной RAG (Retrieval-Augmented Generation) базы и это создает иллюзию, что вопрос решен, но на самом деле – это только начало решения вопроса.
RAG (Retrieval-Augmented Generation) сегодня стал стандартом де-факто. И это логично: он прост в настройке, не требует дорогого обучения и дает быстрый результат. Но у него есть фундаментальные ограничения.
Голый RAG работает так: нарезал документы на куски, нашел похожий по смыслу, скормил модели. Но голый RAG не понимает нефтяную логику. Спросите его про давление — он вам выдаст цитату из любого соседнего абзаца. Это называется 'перекрестное загрязнение', а по-русски — 'каша в голове'.
RAG статичен. Загрузили документы — и всё. Через месяц появились новые исследования, пробурена новая скважина, проведен ГРП. RAG не «запоминает» этот опыт. Единственный способ обновить его — пересобрать векторный индекс, что никак не улучшает глубину понимания модели.
RAG — это стажер в ИИ мире - принесет вам, что просите, но сделать сам без вас ничего не сможет.
В отличие от RAG, обучение (Supervised Fine-Tuning, SFT) вшивает знания и логику предметной области в веса модели. Модель перестает быть «универсальным студентом» и становится «молодым экспертом», который знает вашу терминологию, понимает взаимосвязи и формулирует ответы в принятом в компании стиле.
Отдайте LLM инженерам!
Главное преимущество нашего подхода: обучение становится доступным процессом.
В нефтегазе данные не статичны. Каждый день приносят:
результаты нового бурения — свежие кривые ГИС, керны, отчеты по заканчиванию;
промысловые работы (ГРП, закачка, испытания) — фактические данные, корректирующие модели;
научные исследования — новые методики подсчета запасов и рекомендации.
В классическом подходе (разовый проект с интегратором) это катастрофа. Модель «застывает» на момент внедрения. Через месяц она уже отвечает по устаревшим данным.
Мы перевернули эту логику.
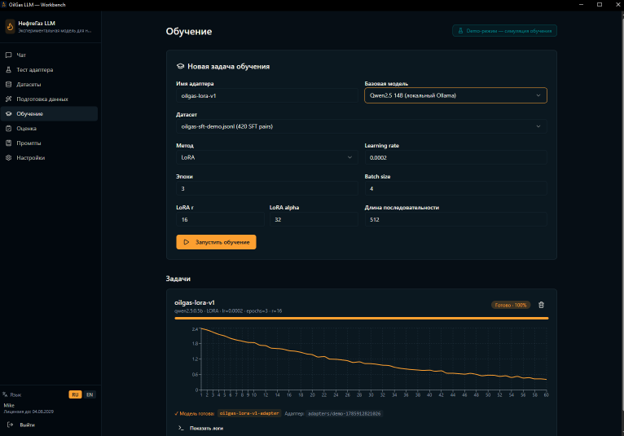
Наше приложение НефтеГаз LLM делает дообучение постоянно действующим конвейером, доступным инженеру или геологу без участия IT-специалистов:
Появился новый отчет — загружаем его в систему.
Система автоматически генерирует новые обучающие пары (вопрос-ответ) с учетом свежих данных.
Инженер нажимает кнопку «Дообучить» — и адаптер модели обновляется за 30–60 минут.
Модель уже отвечает с учетом самого свежего опыта.
Метод Микеланджело – возьми камень и отрежь все лишнее
Мы внедрили концепцию Domain Compression — сжатие модели под целевой домен до основного цикла обучения. Это дает двойной эффект: уменьшаем модель и одновременно «сдвигаем» ее в нефтегазовый контекст.
Этап 1. Чистка словаря токенизатора (минус 15–20% веса бесплатно)
К примеру, у Qwen словарь содержит до 150 тысяч токенов, включая арабские, китайские и прочие иероглифы. Для русско-английского контура они — мертвый груз. Мы вырезаем их из embedding-матрицы. Единственный этап с нулевым риском для качества в нашем домене.
Этап 2. Depth Pruning (удаление целых слоев)
Убираем 20–30% средних слоев модели. Склеиваем оставшиеся. Модель становится на четверть быстрее, почти не теряя в качестве. Это операция «нарезки весов» в Python, не требующая дорогого градиентного обучения.
Этап 3. Лечебный SFT на нефтегазовом датасете
Короткий цикл обучения (500–2000 шагов) на ваших парах «вопрос-ответ». Он одновременно:
«Склеивает» раны после удаления слоев, восстанавливая логику;
Адаптирует модель под вашу терминологию;
«Атрофирует» веса, не задействованные в домене.
Результат: модель, которая на 25–40% легче и быстрее базовой, но показывает сравнимую или более высокую точность на ваших задачах. И все это без передачи данных за контур компании.
Школа языка нефтяников
Главная боль нефтяников — LLM не видит специальных данных. Большинство AI-решений смотрят на LAS-файл как баран на новые ворота. Для них это просто бинарный шум. Мы сделали так, что наша платформа 'видит' каротажные кривые, глубины, координаты — и превращает их в текстовую сводку. Для модели это как перевод с языка скважин на человеческий. Чтобы научить модель правильному языку в нашу платформу включены встроенные геопарсеры, которые кроме обычных форматов читают:
LAS — извлекают кривые ГИС, интервалы глубин, строят графики;
GeoTIFF / ASCII Grid — читают сетки, координаты, статистику;
Shapefile — видят атрибутивную таблицу объектов.
SEG-Y – на подходе.
Мы не просто загружаем файл — мы строим по нему текстовую сводку, которую модель использует для поиска и обучения. Инженер загрузил LAS — система уже знает, сколько скважин, какая глубина, какие кривые записаны.
Архитектура доверия: режимы работы и объективная оценка
В нашей среде инженер не просто «болтает с ботом». Мы внедрили жесткое разделение режимов:
Базовая модель — для общих вопросов (быстро, но поверхностно).
RAG — ответ строго по вашим документам, со ссылкой на конкретный документ и пункт регламента.
Дообученная модель — ответ эксперта, обученного на ваших корпоративных парах.
Без объективной оценки внедрение невозможно. Мы встроили модуль «LLM-судья», который сравнивает ответы базовой и дообученной модели бок о бок (Side-by-Side), прогоняет тест-сет и выдает дельту в баллах. Только увидев цифры, можно понять ценность дообучения.
Итог: что получает предприятие
Переход к нашему подходу дает измеримые эффекты:
Скорость. Поиск ответа в архиве сокращается с часов до секунд.
Сохранение знаний. Опыт экспертов фиксируется в обучающих адаптерах, а не уходит с людьми.
Экономия. Нет необходимости привлекать сторонние сервисы для разовых обучений, все выполняют ваши сотрудники на настроенной архитектуре.
Безопасность. Данные не покидают контур. Ни один промысловый файл и ни один запрос не отправляется наружу.
Живой процесс. Модель обновляется вместе с вашим производством — каждое новое бурение и каждый ГРП делают ее умнее.
Готовое решение. Вам не нужно придумывать с нуля – возьмите нашу основу и развивайте в закрытом контуре.
Мы строим цифровой организм, который дышит и учится вместе с вашей компанией.
Если вы хотите увидеть, как это работает на ваших данных, мы предлагаем организовать совместный пилотный проект и стать одним из пионеров внедрения полноценной специализированной LLM закрытого контура в России.